Porównanie systemów monitoringu: New Relic, Datadog, Graphana + Prometheus i Elastic Stack
Monitoring aplikacji i infrastruktury jest jednym z podstawowych narzędzi pozwalających szybko zauważyć problemy i zrozumieć ich przyczyny. Porównajmy funkcje 4 systemów do zbierania: metryk, logów, alertów oraz APM. Sprawdźmy, ile kosztuje uruchomienie i dalsze utrzymanie każdego z nich.
Wstęp
Monitoring aplikacji i infrastruktury jest jednym z podstawowych narzędzi pozwalających szybko zauważyć problemy i zrozumieć ich przyczyny. Porównajmy funkcje 4 systemów do zbierania: metryk, logów, alertów oraz APM. Sprawdźmy, ile kosztuje uruchomienie i dalsze utrzymanie każdego z nich.
Zakres porównania i założenia
Porównanie obejmuje funkcjonalność oraz koszty utrzymania i rozwoju następujących rozwiązań w małym startupie:
- New Relic — metryki, logi i alerty. Komercyjna usługa nastawiona na automatyczne wykrywanie dużej liczby metryk aplikacji i prezentowanie ich w częściowo konfigurowalnym interfejsie.
- Datadog — metryki, logi i alerty. Podobnie jak New Relic jest to usługa SaaS, która automatycznie zbiera i prezentuje dane.
- Prometheus + Grafana — metryki i alerty. To rozwiązanie open source, w którym większość dashboardów i wykresów trzeba przygotować samodzielnie, choć można skorzystać z repozytorium z gotowymi dashboardami.
- Elastic Stack — metryki, logi i alerty (w wersji płatnej). W analizie uwzględniam zarówno Kibana + Elasticsearch + Beats / Logstash, jak i Elastic APM.
- Kibana + Elasticsearch + Beats / Logstash to rozwiązanie quasi-open-source: część istotnych funkcji jest dostępna wyłącznie w kodzie własnościowym. Stos nadaje się przede wszystkim do logów, ale może również przechowywać metryki. W przeciwieństwie do usług SaaS nie konfiguruje się tu automatycznie wiele widoków, a przykłady dashboardów są rozproszone po GitHubie.
- Elastic APM to dostępny wówczas bezpłatnie produkt z kodem dostępnym na licencji własnościowej. Jego interfejs jest osadzony w Kibanie i, podobnie jak New Relic APM, automatycznie wykrywa metryki aplikacji.
Podane wyceny są orientacyjne.
Założenia co do kosztu pracy programisty:
- 15 000 zł miesięcznie brutto dla programisty = 210 840 zł rocznego kosztu pracodawcy,
- 253 dni robocze w 2020 roku - 26 dni urlopu - 8 dni chorobowego / urlopu na żądanie / itp. = 219 dni pracy,
- koszt dnia pracy (8 godzin) = 963 zł,
- koszt godziny pracy = 120 zł.
Pozostałe założenia:
- 1 host dla usług produkcyjnych = 6 vCPU i 16 GB RAM oraz 10 MB logów dziennie,
- 1 USD = 4 PLN.
Podstawowy koszt utrzymania
W tej sekcji uwzględniam instalację, hosting, kopie zapasowe, aktualizacje i bieżące utrzymanie.
New Relic
| Moduł / cennik | 1 host | 2 hosty | 3 hosty | Komentarz |
|---|---|---|---|---|
| APM (host based pricing) | 596 zł / m | 1192 zł / m | 1788 zł / m | Dużo bardzo użytecznych metryk dla każdego endpointu i każdej metody biznesowej; w innych narzędziach trzeba je dodatkowo skonfigurować na dashboardach |
| Logs (8 dni retencji) | 1100 zł / m | 1100 zł / m | 1100 zł / m | Minimalny pakiet danych jest dla nas zdecydowanie zbyt duży |
| Logs (30 dni retencji) | 1744 zł / m | 1744 zł / m | 1744 zł / m | |
| Infrastructure | 79 zł / m | 158 zł / m | 237 zł / m | Dość standardowe metryki, które mamy również na DigitalOcean |
| Moduł / cennik | Cena | Komentarz |
|---|---|---|
| Insights | bezpłatnie dla 90 dni retencji, 1000 zł / m za 75 mln eventów | Dodatkowy koszt trzeba byłoby doliczyć, jeśli chcielibyśmy przechowywać tam wieloletnią historię metryk biznesowych |
| Browser | 596 zł / 0,5 mln pageviews / m | Po przekroczeniu 0,5 mln odsłon można zastosować sampling, ponieważ większa próba danych zazwyczaj nie jest potrzebna |
Podane ceny są cenami netto.
Przykładowe kombinacje:
- na start: 1 host z APM + Logs (9 dni) = 1696 zł / m,
- po wdrożeniu bez przestojów: 2 hosty z APM + Logs (30 dni) = 2936 zł / m,
- w przyszłości: 3 hosty z APM + Logs (30 dni) + Browser = 3532 zł / m.
Datadog
| Moduł | 1 host | 2 hosty | 3 hosty | Komentarz |
|---|---|---|---|---|
| APM | 124 zł / m | 248 zł / m | 372 zł / m | |
| Logs (50k event / host / dzień, 8 dni retencji) | 8 zł / m | 16 zł / m | 24 zł / m | |
| Logs (500k event / host / dzień, 30 dni retencji) | 160 zł / m | 240 zł / m | 400 zł / m | |
| Infrastructure | 60 zł / m | 120 zł / m | 180 zł / m | APM trzeba wykupić razem z Infrastructure |
| Moduł / Pricing | Cena | Komentarz |
|---|---|---|
| Real User Monitoring | 60 zł / 10k sesji / m | Możliwy sampling, aby nie przekroczyć minimalnego limitu |
Przykładowe kombinacje:
- na start: 1 host z APM + Infrastructure + Logs (50k e / h / d, 30 dni r.) = 192 zł / m,
- po wdrożeniu bez przestojów: 2 hosty z APM + Infrastructure + Logs (500k e / h / d, 30 dni r.) = 608 zł / m,
- w przyszłości: 3 hosty z APM + Infrastructure + Logs (500k e / h / d, 30 dni r.) + Real User Monitoring = 1012 zł / m.
Prometheus + Grafana
Funkcjonalność: metryki.
Podstawowa instalacja i integracja: 2–4 dni pracy (1 926–3 852 zł).
Dodatkowa konfiguracja High Availability (monitoring i redundancja): 2–4 dni pracy (1 926–3 852 zł).
Nie twierdzę, że potrzebujemy HA, ale warto pamiętać, że w New Relic otrzymujemy je w praktyce w cenie usługi.
Bieżące utrzymanie (aktualizacje, drobne poprawki konfiguracji, okazjonalne sprawdzenie, czy wszystko działa itp.): 0,5–1 dnia pracy / m (481–963 zł / m).
| Obsługa | 1 host | 2 hosty | 3 hosty | Komentarz |
|---|---|---|---|---|
| Zasoby | 0.25 CPU 0.6 GB RAM | 0.5 CPU 1.2 GB RAM | 1 CPU 2.4 GB RAM | |
| Cena | 13 zł / m | 26 zł / m | 52 zł / m | |
| Zasoby dla HA (2 instancje) | 1 CPU 2.4 GB RAM | 2 CPU 4.8 GB RAM | HA opiera się tu na dwóch instancjach równolegle zasilanych danymi. Przy bardzo dużych systemach skalowalność jest ograniczona. | |
| Cena dla HA (2 instancje) | 52 zł / m | 104 zł / m |
Cenę obliczono jako proporcjonalny koszt serwera z 16 GB RAM i 6 vCPU, kosztującego 320 zł / m na DigitalOcean.
Elastic Stack self-hosted
Funkcjonalność: metryki oraz agregacja i indeksowanie logów.
Podstawowa instalacja i integracja: 3–5 dni pracy (2 889–4 815 zł).
Dodatkowa konfiguracja High Availability (monitoring i redundancja): 2–4 dni pracy (1 926–3 852 zł).
Bieżące utrzymanie (aktualizacje, drobne poprawki konfiguracji, okazjonalne sprawdzenie, czy wszystko działa itp.): 1–2 dni pracy / m (963–1 926 zł / m).
| Obsługa | 1 host | 2 hosty | 3 hosty | Komentarz |
|---|---|---|---|---|
| Zasoby | 0.5 CPU 1.2 GB RAM | 1 CPU 2.4 GB RAM | 2 CPU 4.8 GB RAM | |
| Cena | 26 zł / m | 52 zł / m | 104 zł / m | |
| Zasoby dla HA (3 instancje) | 3 CPU 6.0 GB RAM | Sharding z replikacją każdego shardu na 2 instancje | ||
| Cena dla HA (3 instancje) | 156 zł / m |
Elastic Stack Cloud
Minimalna konfiguracja w architekturze hot-warm (pod logi i monitoring), zalecana właściwie tylko do testów:
- 1 zone
- aws.data.highio.i3 (data) - 1 GB RAM x 1, 30 GB storage x 1
- aws.data.highstorage.d2 (data) - 2 GB RAM x 1, 320 GB storage x 1
- aws.kibana.r4 (kibana) - 1 GB RAM x 1
- aws.apm.r4 (apm) - 512 MB RAM x 1
Cena: 367 zł / m
Minimalna zalecana konfiguracja produkcyjna:
- 1 zone
- gcp.data.highio.1 (data) - 4 GB RAM x 1, 120 GB storage x 1
- gcp.data.highstorage.1 (data) - 4 GB RAM x 1, 640 GB storage x 1
- gcp.kibana.1 (kibana) - 1 GB RAM x 1
- gcp.apm.1 (apm) - 512 MB RAM x 1
Cena: 876 zł / m
Ceny nie obejmują transferu danych ani kosztu przechowywania snapshotów — dostawca nalicza je oddzielnie.
Koszty w dużej skali
Z mojego doświadczenia wynika, że New Relic staje się bardzo drogi przy serwisach o naprawdę dużej skali (setki tysięcy użytkowników i dziesiątki serwerów).
Przy 50 hostach sam APM będzie kosztował już 29 800 zł miesięcznie.
Przy takiej kwocie zaczyna opłacać się zatrudnienie dwóch DevOpsów do utrzymania większej instalacji Elastic Stack wraz z Prometheusem i Grafaną oraz do automatyzacji tworzenia metryk i dashboardów dla organizacji.
Metryki
Model metryk
- Prometheus
- ✅ z założenia wspiera hierarchiczny model metryk wraz z tagami, co pozwala analizować dane wielowymiarowo (multi-dimensional metrics),
- ✅ jako dedykowana baza danych dla metryk zapewnia bardzo dobrą kompresję przechowywanych danych.
- Elasticsearch
- ✅ metryki również mogą być wielowymiarowe, ponieważ przechowywane są tu pojedyncze zdarzenia wraz z danymi kontekstowymi,
- ⚠ ponieważ przechowujemy zdarzenia, przy dużej ilości danych potrzebna jest dodatkowa praca nad ich kompresją. Mimo wielu optymalizacji Elasticsearch nigdy nie będzie pod tym względem tak wydajny jak Prometheus (źródło).
- New Relic Insights:
- ✅ hierarchiczny model metryk, do którego stosunkowo niedawno dodano tzw. facety, zapewnia obsługę wielowymiarowości; podobno został już zintegrowany ze Spring Metrics,
- ⚠ w rozwiązaniu SaaS nie musimy martwić się o sposób przechowywania danych, ale trudno ocenić, czy 1000 zł / m za retencję 75 mln eventów to dużo czy mało.
- Datadog:
- ✅ od dawna wspiera hierarchiczny model metryk wraz z tagami,
- ❓ nie udało mi się ustalić, ile kosztuje dłuższa retencja.
Niestandardowe metryki aplikacji
Wszystkie systemy wspierają Spring Metrics. Wystarczy przygotować odpowiednią metrykę po stronie aplikacji, a po skonfigurowaniu importu utworzyć dla niej wykres w Kibanie, Grafanie lub New Relic Insights.
Metryki middleware
Tu zdecydowanym liderem jest Prometheus, który jest natywnie wspierany przez wiele systemów albo ma eksportery dostępne w osobnych projektach open source (lista).
Dlatego format eksporterów Prometheusa staje się de facto standardem i mogą go odczytywać zarówno:
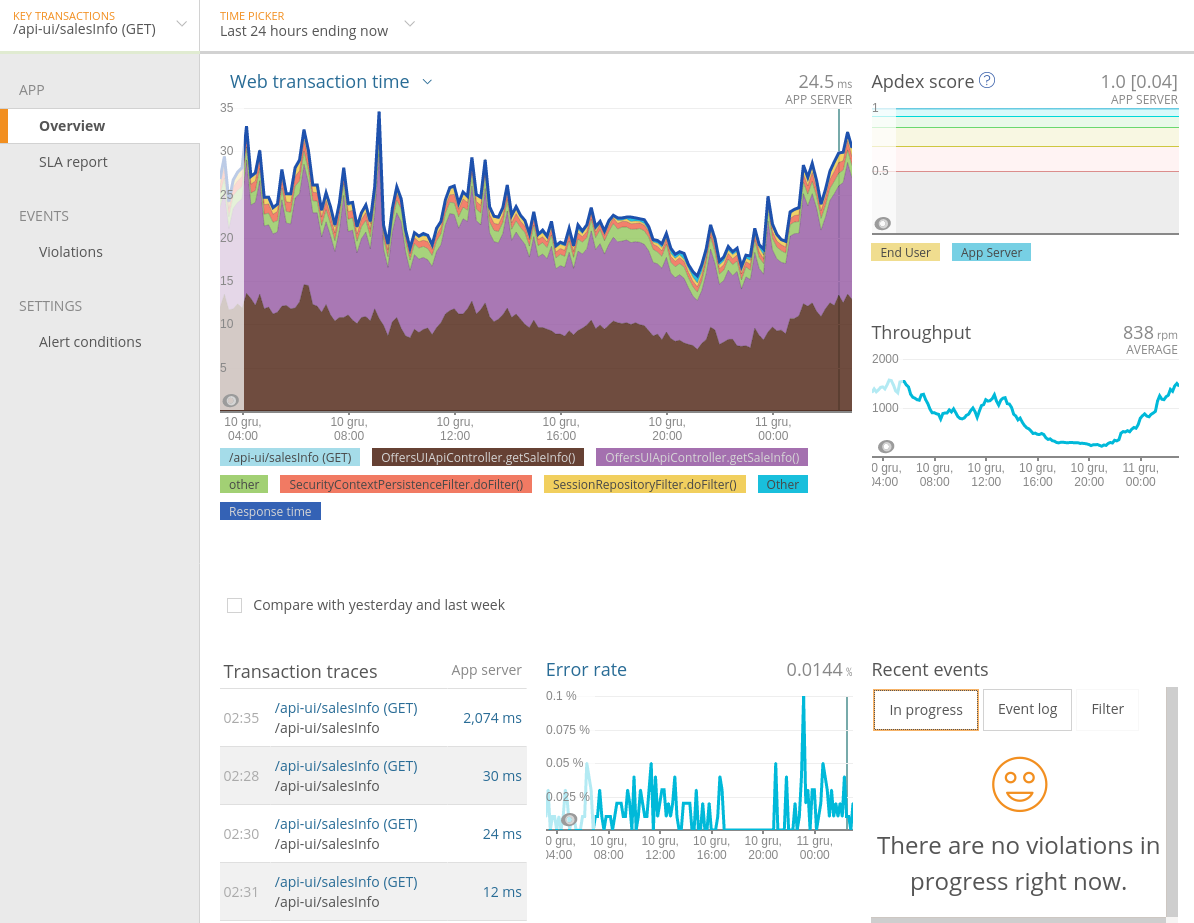
Metryki aplikacji dostępne od razu w New Relic
Metryki transakcji kluczowej
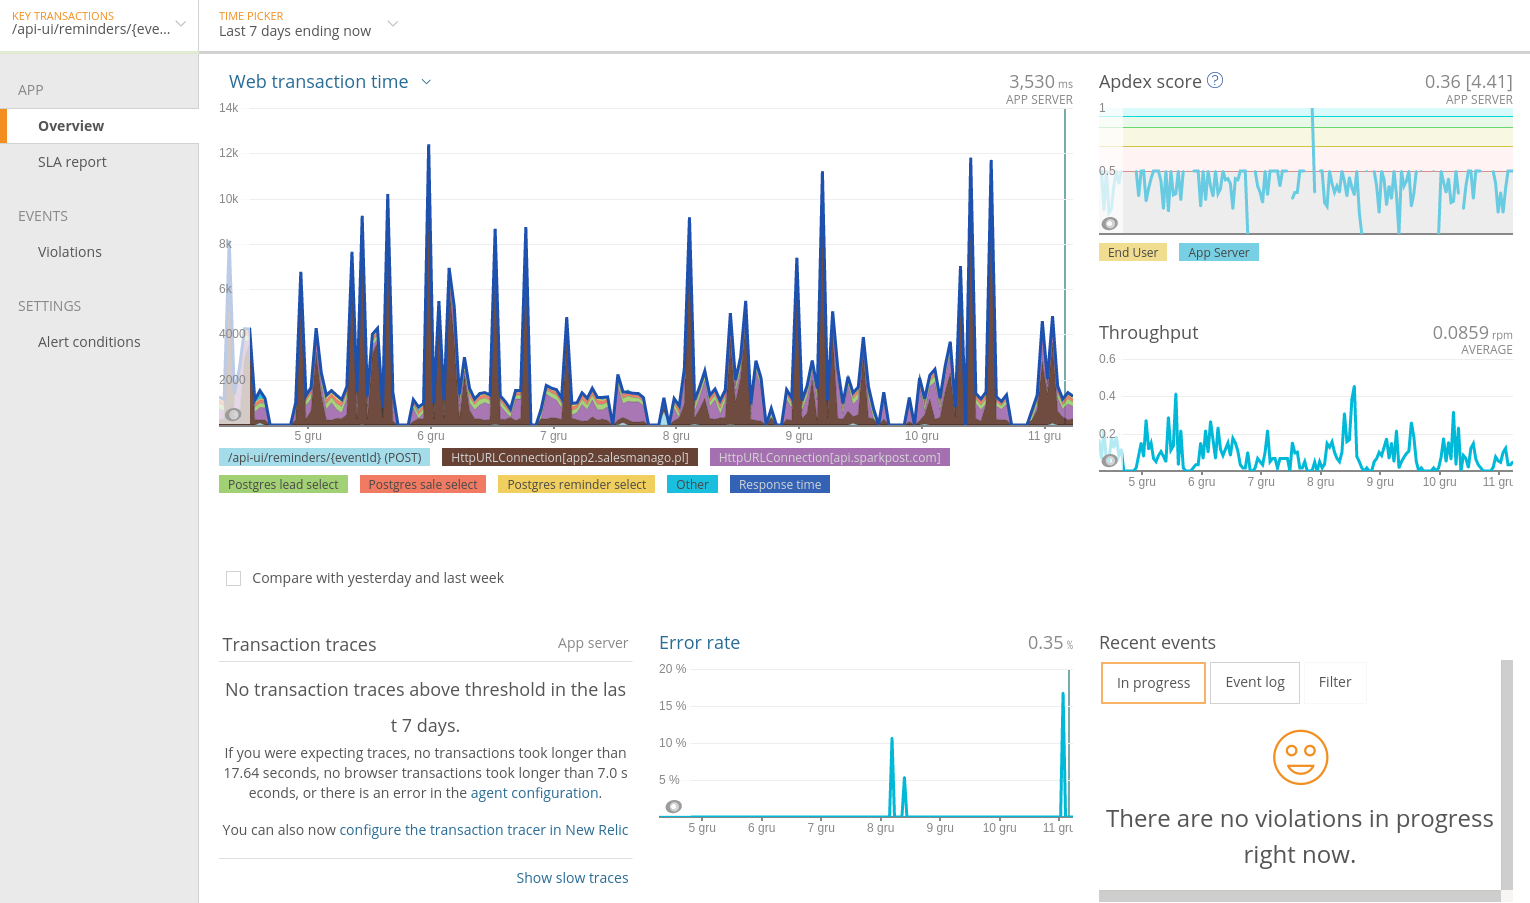
Koszt przygotowania podobnych widoków w konkurencyjnych narzędziach:
- skryptu z szablonem dashboardu zawierającym proste metryki:
- Web transaction time (tylko średnia)
- Throughput
- Error rate
- Apdex
- koszt w Grafanie lub Kibanie:
- 4 dni pracy (3 852 zł) na opracowanie skryptu,
- następnie 1 godzina pracy (120 zł) na utworzenie i przetestowanie dashboardu dla każdej transakcji,
- w Elastic Stack APM prawdopodobnie pozostaje to jeszcze do zrobienia,
- Web transaction time (stos sekcji)
- Prometheus: 1 dzień pracy (963 zł) na transakcję plus 1 godzina pracy, gdy zmienią się sekcje,
- Elastic Stack bez APM:
- 4 dni pracy na opracowanie skryptu i konwersję oznaczania sekcji na Spring Metrics (w tym celu istnieje komponent),
- następnie 1 godzina pracy (120 zł) na utworzenie i przetestowanie dashboardu dla każdej transakcji,
- Elastic APM / Datadog APM — zobacz zestawienie na końcu artykułu,
- najwolniejszych pojedynczych transakcji:
- Prometheus — cięzko powiedzieć, jest to trudne do wykonania w tym systemie,
- Elastic APM / Datadog APM — zobacz zestawienie na końcu artykułu.
Metryki pojedynczej wolnej transakcji
New Relic rejestruje szczegóły transakcji, które trwały wyjątkowo długo.
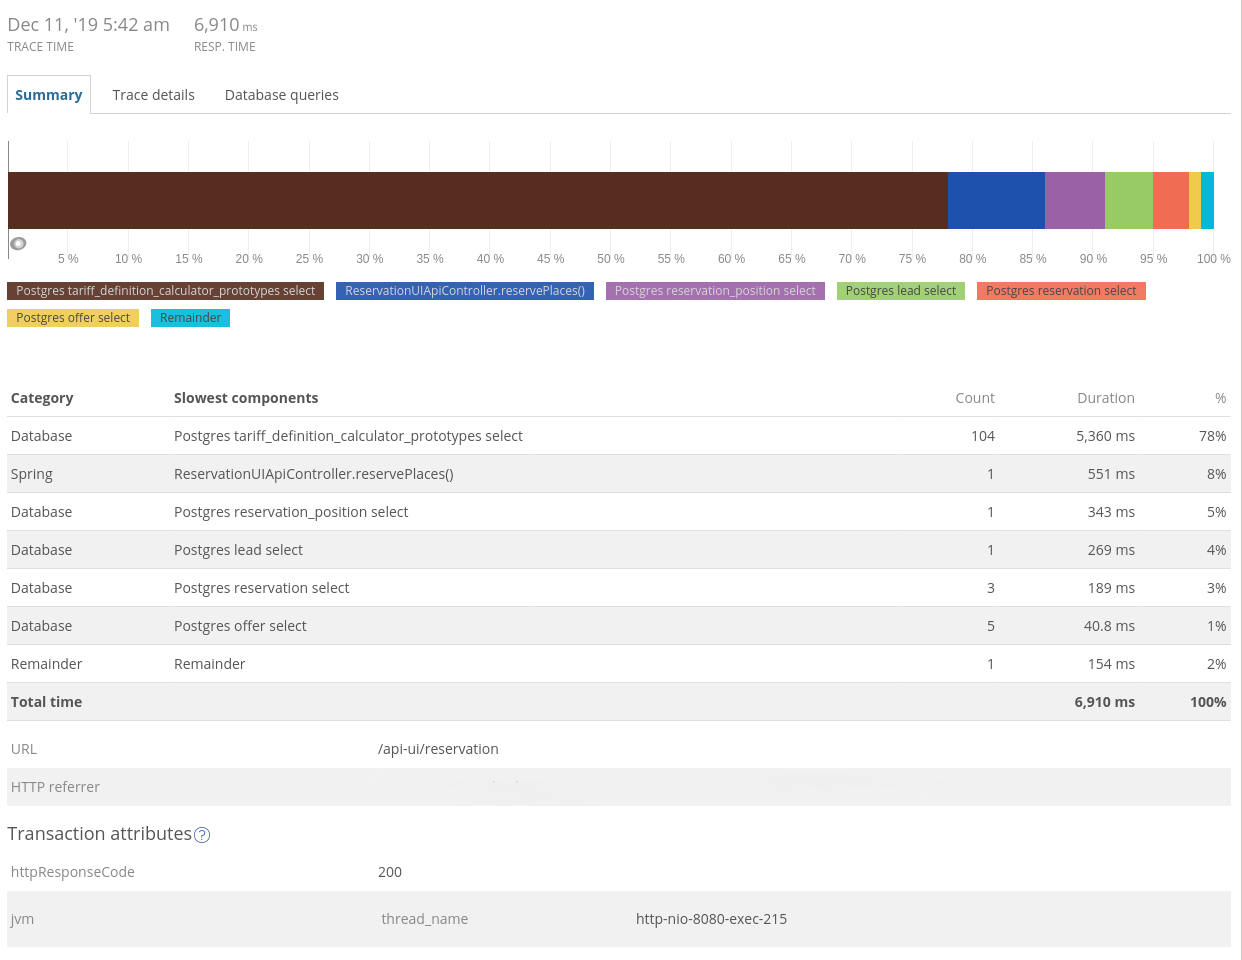
Koszt przygotowania podobnego widoku w narzędziach konkurencyjnych:
- Prometheus — niewykonalne,
- Elastic APM / Datadog APM — zobacz zestawienie na końcu artykułu.
Podsumowanie stanu wszystkich transakcji w aplikacji
Całego klastra.
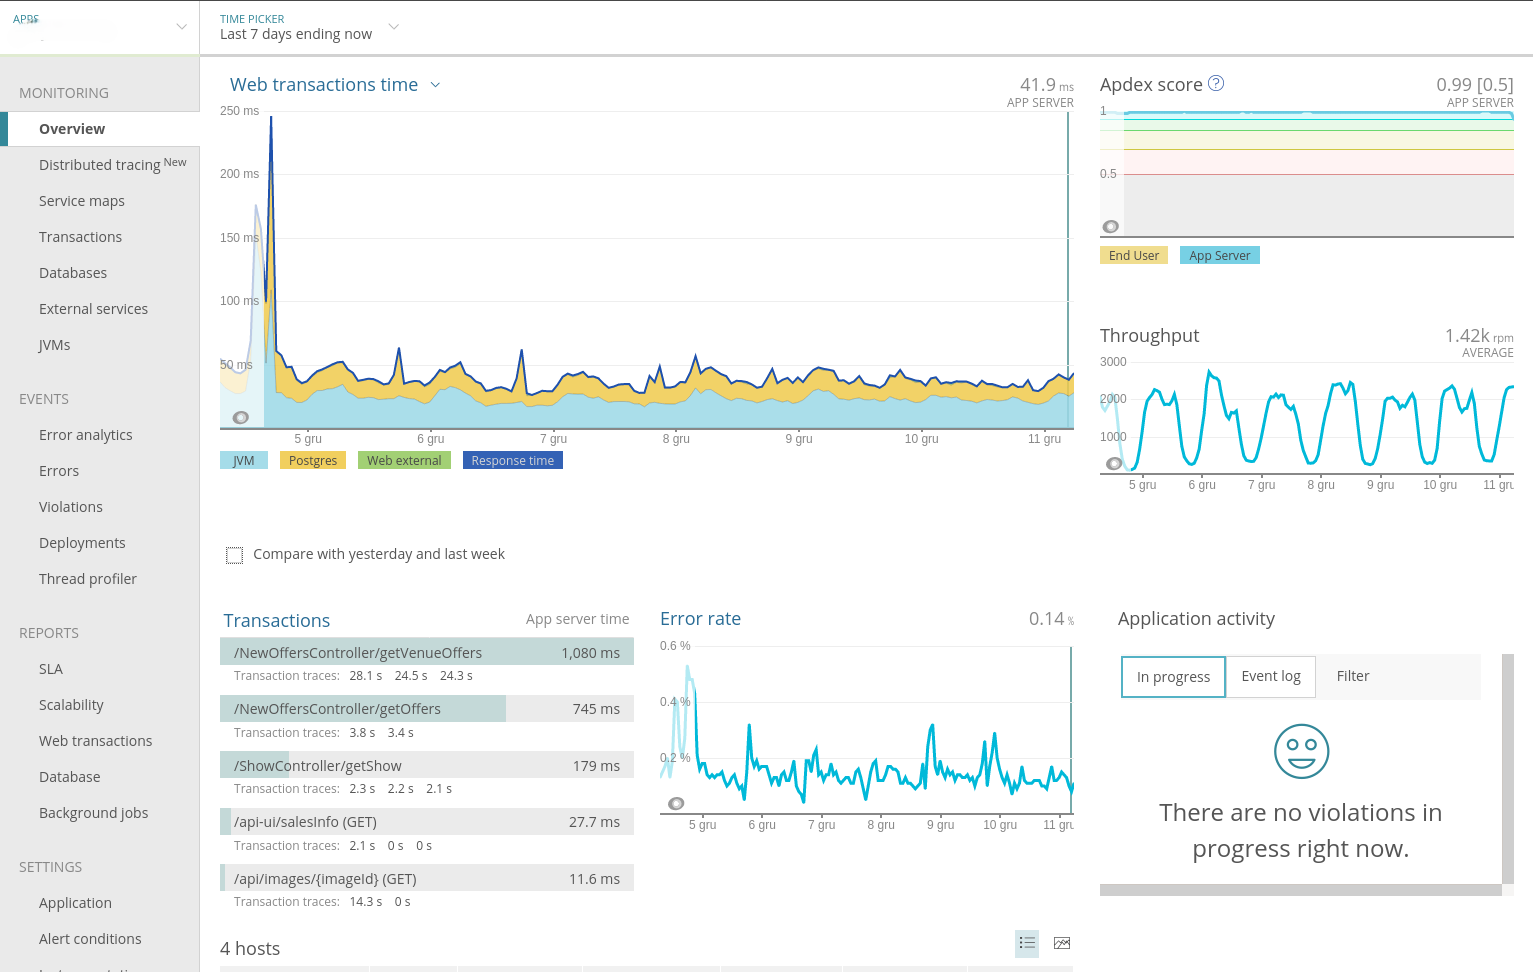
- Prometheus — 3 dni pracy (2 889 zł) na wypracowanie konwencji i dashboardu,
- Elastic APM / Datadog APM — zobacz zestawienie na końcu artykułu.
Zestawienie najważniejszych transakcji
Najbardziej obciążających serwer, najwolniejszych, najczęściej uruchamianych oraz tych z najgorszym wynikiem Apdex.
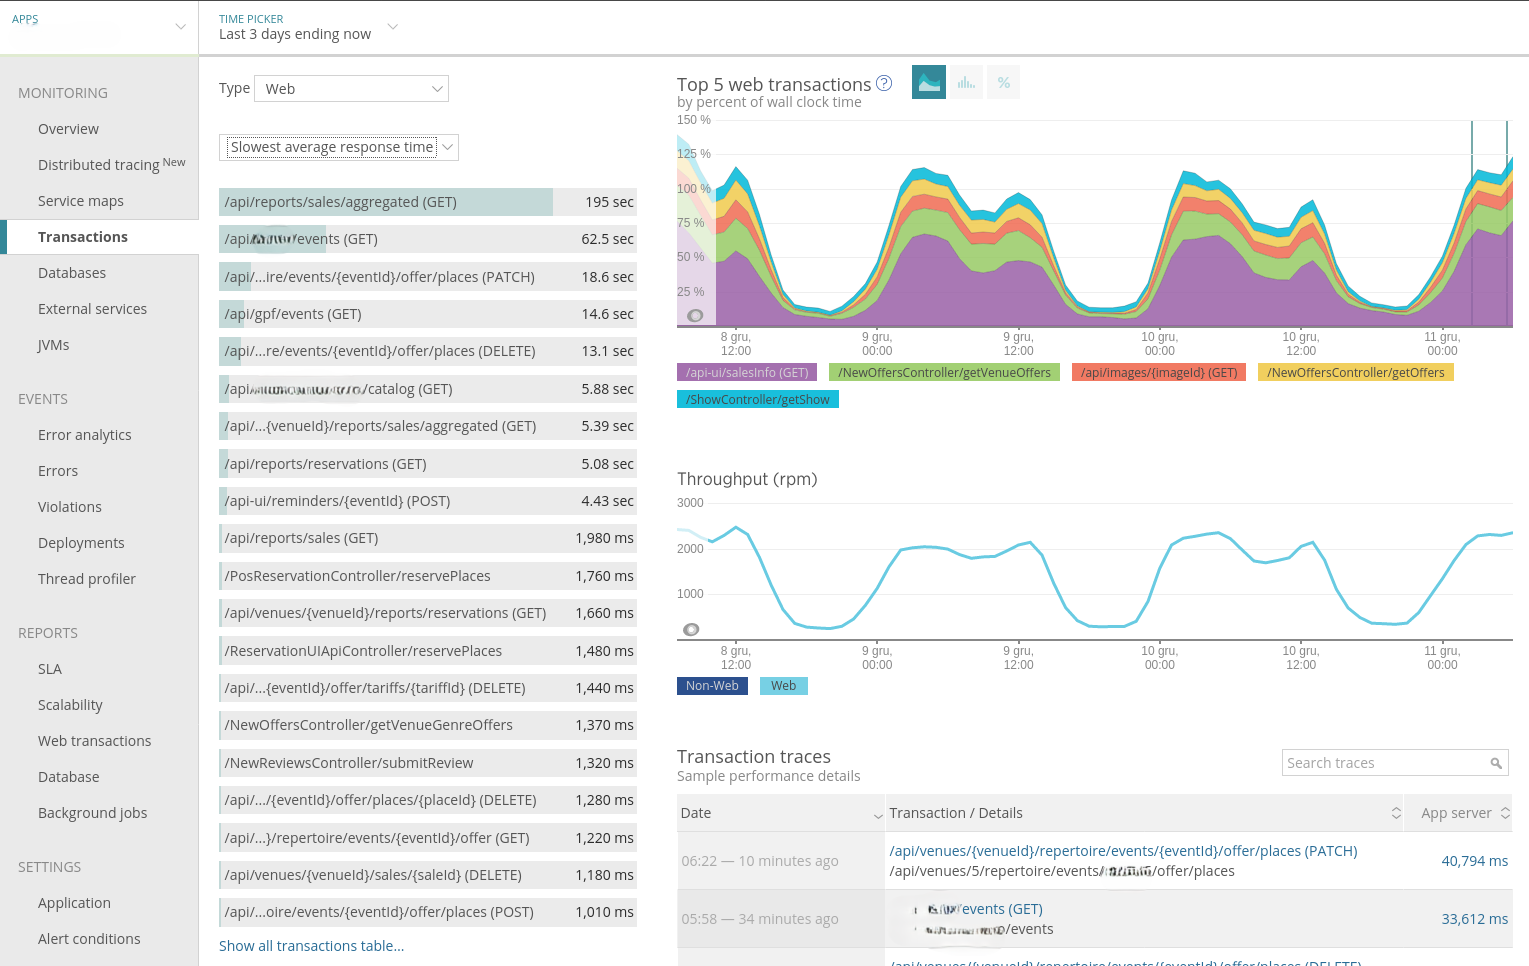
Koszt przygotowania podobnego widoku w narzędziach konkurencyjnych:
- Prometheus — nie wydaje się to wykonalne,
- Elastic bez APM — 3 dni pracy (2 889 zł) na dashboard zawierający same tabele,
- Elastic APM / Datadog APM — zobacz zestawienie na końcu artykułu.
Zestawienie najwolniejszych zapytań do bazy danych
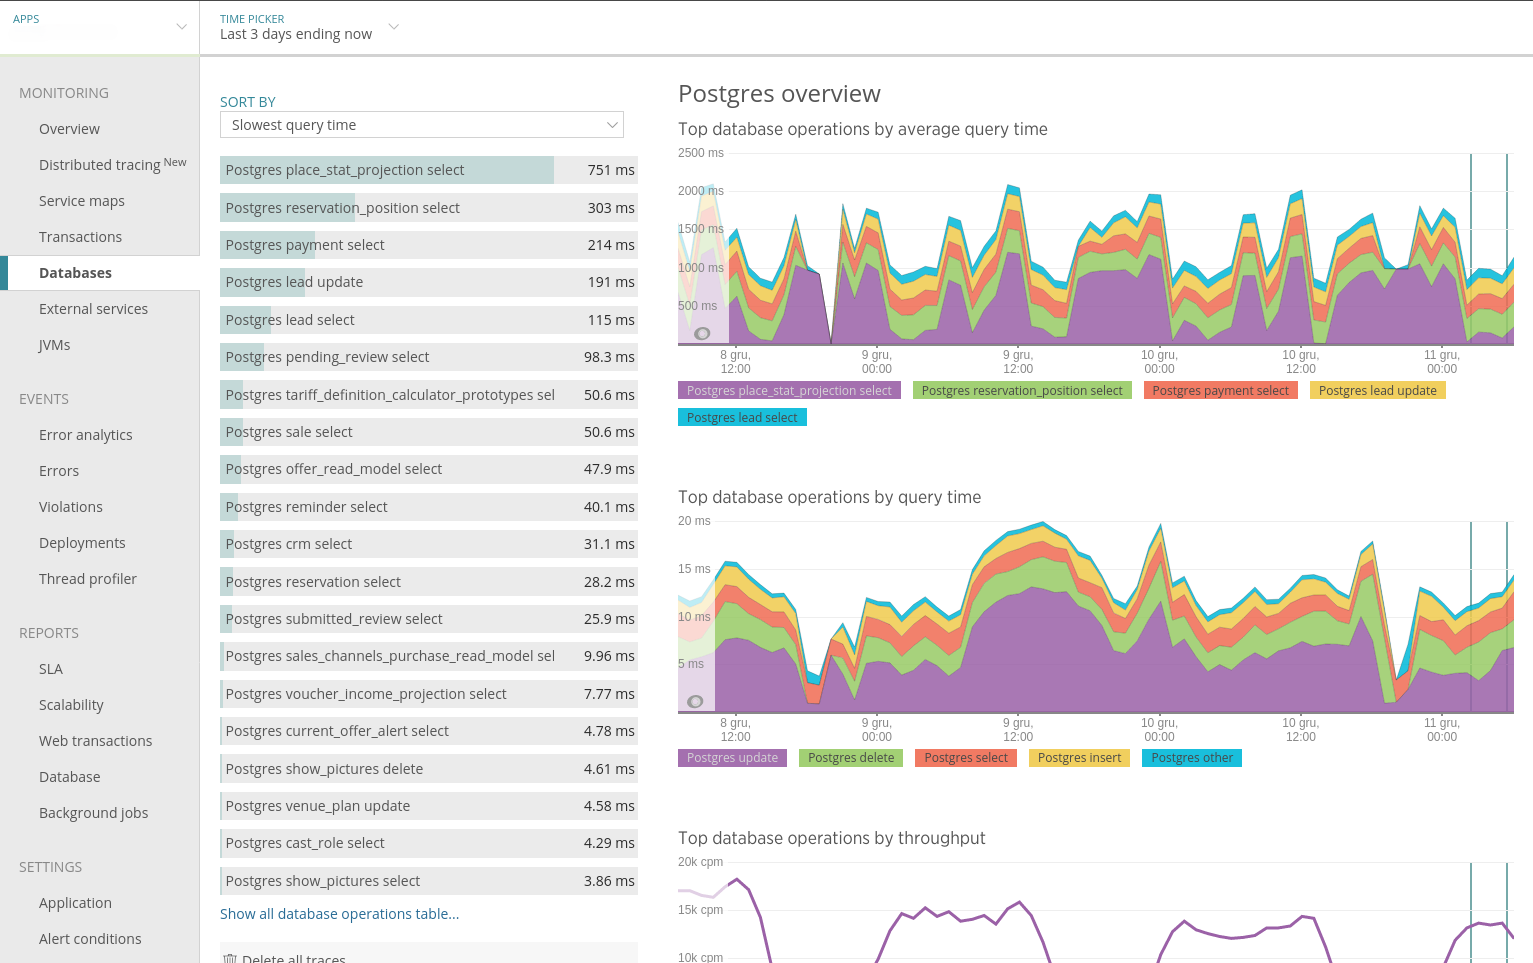
Koszt przygotowania podobnego widoku w narzędziach konkurencyjnych:
- Prometheus — nie wydaje się to wykonalne,
- Elastic bez APM — 3 dni pracy (2 889 zł) na dashboard zawierający same tabele,
- Elastic APM / Datadog APM — zobacz zestawienie na końcu artykułu.
Metryki wykonania danego zapytania do bazy
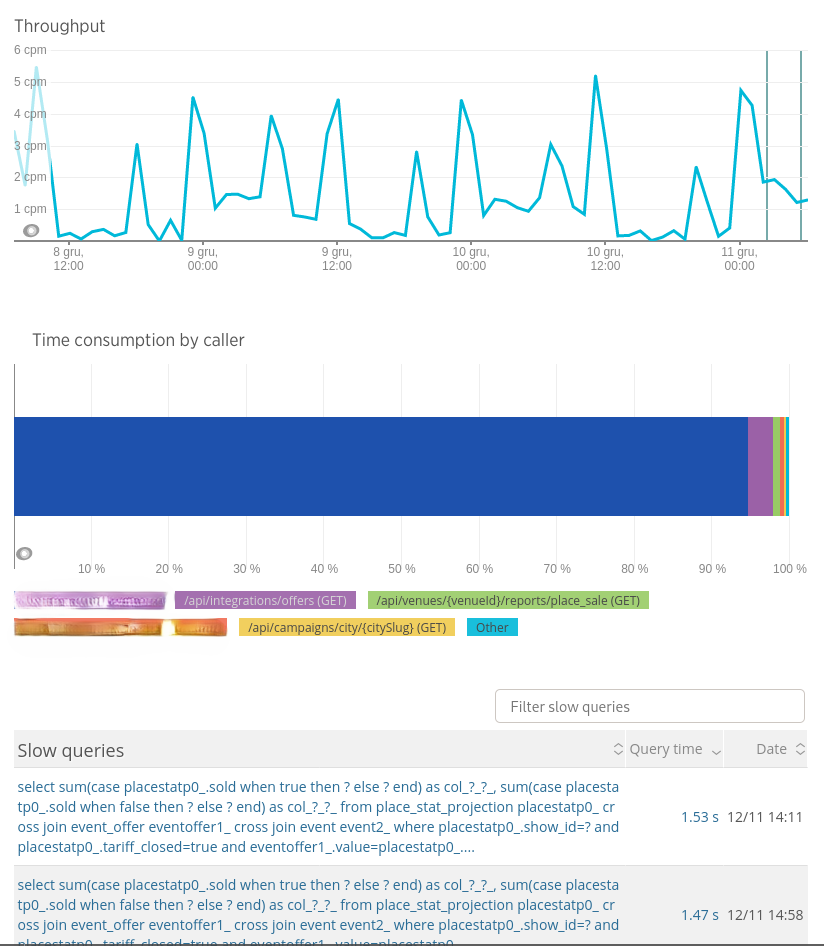
Koszt przygotowania podobnego widoku w narzędziach konkurencyjnych:
- Prometheus — nie wydaje się to wykonalne,
- Elastic bez APM — 2 dni pracy (1 926 zł) na dashboard zawierający same tabele,
- Elastic APM / Datadog APM — zobacz zestawienie na końcu artykułu.
Metryki JVM
New Relic APM, Elastic APM i Datadog APM oferują gotowy widok. Dla Grafany dostępny jest gotowy szablon.
Metryki integracji z zewnętrzną usługą
New Relic ma tu dość uproszczony widok, ponieważ nie rozbija danych na endpointy zewnętrznej usługi.
Agregacja i przeszukiwanie logów
Elastic Stack:
- jest zdecydowanie najbardziej rozbudowanym rozwiązaniem,
- wspiera MDC i logi strukturalne,
- dobrze radzi sobie z dużą ilością danych. Z mojego doświadczenia na trzymaszynowym klastrze:
- 12 GB logów dziennie
- 60 dni retencji
- wyszukiwanie pełnotekstowe z ostatnich 7 dni zwracało wyniki natychmiast, a dla 60 dni opóźnienie czasami wynosiło 2–3 sekundy.
New Relic Logs:
- trudno mi je ocenić — wygląda raczej na proste rozwiązanie dla systemów, które nie generują gigabajtów logów.
Alerty
We wszystkich analizowanych systemach można:
- dla każdej metryki ustawić próg, którego przekroczenie powoduje zgłoszenie incydentu,
- skonfigurować powiadomienia e-mail, w Slacku lub w systemie zarządzania incydentami, takim jak PagerDuty.
W Elastic Stack alertowanie było wówczas dostępne dopiero w płatnej licencji Gold, która kosztowała:
- w wersji hostowanej 5 500 € rocznie za węzeł; przydatne są 3 węzły, aby zachować integralność danych (źródło),
- w wersji SaaS — podobno od 16 USD miesięcznie dla najmniejszej instalacji Standard, w której alertowanie jest już dostępne, choć ta cena wymagała dokładniejszej weryfikacji.
Istniał również poboczny projekt open source dodający tę funkcjonalność, ale trudno było ocenić jego dojrzałość: ElastAlert.
Pozostałe funkcje
- Przeglądanie błędów — New Relic oferuje funkcje podobne do Sentry, choć nieco mniej rozbudowane.
- Monitoring przeglądarki — New Relic ma dobre rozwiązanie, które wykrywa wyjątki JavaScript i zbiera statystyki czasu renderowania strony.
- Wykrywanie anomalii — liderem jest Elastic Stack, którego komponenty od dawna są optymalizowane pod kątem machine learningu. New Relic oferuje proste wykrywanie wartości odstających, choć wspomina również o New Relic AI. W Grafanie funkcja ta była wówczas dopiero planowana (dyskusja).
Zestawienie APMów
| Funkcja | New Relic APM | Elastic APM | Datadog APM | Komentarz |
|---|---|---|---|---|
| Metryki kluczowych transakcji: | ||||
| średni czas wykonania | ✅ | ✅ | ✅ | |
| throughput | ✅ | ✅ | ✅ | |
| error rate | ✅ | ⛔ ⚠ | ✅ | Elastic dla żądań HTTP ma statystykę kodów odpowiedzi, ale dla zadań działających w tle nie ma nic |
| apdex (error rate + długie wykonania) | ✅ | ⛔ | ✅ | |
| czasy wewnątrz transakcji (Java, SQL, HTTP client itp.) | ✅ | ✅ ✅ | ✅ ✅ | Elastic i Datadog mają lepszą wizualizację oraz bardziej szczegółowy, zagnieżdżony podział transakcji |
| trace najwolniejszych transakcji | ✅ | ✅ | ✅ | |
| Podsumowanie stanu wszystkich transakcji: | ||||
| średni czas wykonania | ✅ | ✅ | ✅ | |
| throughput | ✅ | ✅ | ✅ | |
| error rate | ✅ | ⛔ ⚠ | ✅ | Elastic dla żądań HTTP ma statystykę kodów odpowiedzi, ale dla zadań działających w tle nie ma nic |
| apdex (error rate + długie wykonania) | ✅ | ⛔ | ✅ | |
| czasy wewnątrz transakcji (Java, SQL, HTTP client, itp.) | ✅ | ✅ | ✅ | |
| Zestawienie najważniejszych transakcji: | ||||
| najbardziej zajmujących serwer | ✅ | ✅ | ✅ | |
| najwolniejszych | ✅ | ✅ | ✅ | |
| najczęściej używanych | ✅ | ✅ | ✅ | |
| najgorszy apdex | ✅ | ⛔ | ⛔ | |
| Zestawienie najważniejszych zapytań do bazy danych: | ||||
| najbardziej zajmujące serwer | ✅ | ⛔ | ✅ | |
| najwolniejszych | ✅ | ⛔ | ✅ | |
| najczęściej wołanych | ✅ | ⛔ | ✅ | |
| największy error rate | ⛔ | ⛔ | ✅ | |
| Metryki wykonania danego zapytania | ✅ | ⛔ | ✅ | |
| Metryki JVM (stos, GC, itp.) | ✅ | ✅ | ✅ | |
| Alerty na powyższych metrykach | ✅ | ⚠ | ✅ | W Elastic alerty zakłada się bezpośrednio na danych w bazie. Jest to mało wygodne i wymaga wiedzy o tym, jak APM buduje widoki z tych danych. |
| Logi w kontekście metryk | ⚠ | ✅ | ✅ | W New Relic logi są drogie na start i wymagają zainstalowania dodatkowego middleware. |
| Support | ✅ | ⚠ | ✅ | Wszystkie firmy odpowiadają w ciągu kilku godzin, ale tylko przedstawiciele Elastic nie potrafili udzielić konkretnej odpowiedzi na techniczne pytania. |
Podsumowanie
New Relic i Datadog pozwalają szybko uzyskać gotowe widoki APM, metryk i alertów, ale wygoda usług SaaS wiąże się z miesięcznym kosztem, który rośnie wraz ze skalą. Prometheus z Grafaną jest najtańszy w utrzymaniu i bardzo elastyczny w obszarze metryk, jednak wymaga większego nakładu pracy na przygotowanie dashboardów oraz bieżącą obsługę.
Elastic Stack najlepiej sprawdza się tam, gdzie kluczowe są logi i ich przeszukiwanie, ale własna instalacja oznacza dodatkową pracę operacyjną, a część funkcji wymaga płatnej licencji. W praktyce wybór powinien zależeć przede wszystkim od tego, czy ważniejsza jest szybkość uruchomienia i gotowe widoki, niski koszt utrzymania metryk, czy możliwość samodzielnego skalowania i analizy dużych ilości logów.